Explorar las categorías
Explora
Fiverr Pro
Español
$
USD

Level 2
Traducción automática
Datos sintéticos de IA y evaluación de modelos
EL PROBLEMA
Datos de entrenamiento deficientes pueden causar alucinaciones, resultados inconsistentes y problemas costosos en producción. La etiquetación manual de datos específicos es lenta y cara.
LA SOLUCIÓN
Creamos conjuntos de datos sintéticos listos para producción con casos límite realistas y pipelines de evaluación automatizados para probar la precisión, latencia y fiabilidad del modelo.
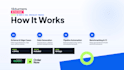
LO QUE ENTREGAMOS
POR QUÉ TKTURNERS
Ingeniería de IA especializada en datos de alta calidad, generación estructurada y evaluación confiable de modelos.
ENTREGA RÁPIDA
Obtén conjuntos de datos validados y pipelines de benchmarking listos para ajuste fino o evaluación en producción.
REVISIÓN GRATUITA DE DATOS
Envía un mensaje antes de ordenar para una revisión gratuita de estrategia de datos y esquema.
Senior Software Engineer
Level 2
Idiomas
Traducción automática
Traducción automática
¿Por qué debo enviarle un mensaje antes de ordenar?
La comunicación previa nos permite revisar tu esquema de datos, requisitos del dominio y objetivos de evaluación para ajustar el paquete adecuado y evitar retrasos en la entrega.
¿Qué es datos de entrenamiento sintéticos y cómo se usan?
Los datos de entrenamiento sintéticos son datos generados artificialmente que imitan distribuciones del mundo real. Permiten ajustar y probar modelos de IA sin riesgos de privacidad ni costos de etiquetado manual.
¿Qué formatos de datos soportas?
Entregamos datos en formatos JSONL, CSV, Parquet, JSON y formatos estándar de datasets de Hugging Face, optimizados para ajuste fino de modelos OpenAI, Anthropic o de código abierto.
¿Cómo aseguras que los datos sintéticos sean de alta calidad?
Utilizamos restricciones de esquema, deduplicación semántica, verificaciones de distribución estadística y reglas de validación automatizadas para eliminar alucinaciones y errores de formato.
¿Qué incluye el pipeline de evaluación de modelos?
El pipeline incluye pruebas automatizadas de benchmarking, puntuación de precisión, seguimiento de latencia, evaluación con LLM como juez y reportes de pruebas de regresión.
¿Incluyen costos de uso de API y modelos de terceros?
No, los costos de uso de API (OpenAI, Anthropic o computación en la nube) se facturan directamente a tu cuenta. Asistimos con la configuración clave y la optimización del presupuesto.
¿Qué acceso o información necesitas para comenzar?
Necesitamos tu esquema objetivo, ejemplos de datos de muestra (si están disponibles), reglas del dominio del negocio y los criterios o métricas de evaluación que deseas benchmarking.
¿Cómo se mantiene privada mi información empresarial propietaria?
Firmamos acuerdos de confidencialidad estándar, nunca almacenamos tus datos sensibles de forma permanente y generamos conjuntos de datos completamente anonimizado y en cumplimiento con la privacidad.
¿Cómo funcionan las revisiones para la generación de datasets?
Las revisiones incluyen ajustar la distribución del dataset, modificar casos límite, perfeccionar plantillas de prompts o volver a ejecutar métricas específicas de evaluación.
¿Ofrecen mantenimiento continuo del pipeline?
Sí, ofrecemos mantenimiento continuo y expansión de datasets mediante hitos personalizados o paquetes de soporte mensual.


