Explorar las categorías
Explora
Fiverr Pro
Español
$
USD

Level 2


Traducción automática
AJUSTE FINO DE LLM PERSONALIZADOS
Los modelos de IA genéricos pueden inventar o fallar en tus flujos de trabajo. Ajusta finamente con tus datos, formato y conocimientos del dominio propios.
ENTREGAS Y VELOCIDAD
LA SOLUCIÓN
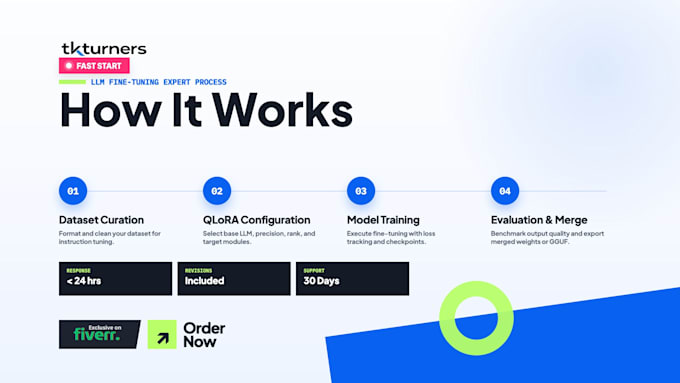
Construimos conjuntos de datos de instrucciones limpias, optimizamos los parámetros rank/alpha y ajustamos modelos para mejorar el rendimiento en el dominio y reducir los costos de inferencia.
POR QUÉ TKTURNERS
Ingenieros de IA de pila completa que entregan modelos listos para producción y automatización de flujos de trabajo adaptados a las necesidades de tu negocio.
GARANTÍA DE CALIDAD
Cada modelo se evalúa con prompts de prueba acordados. Si los resultados no alcanzan las métricas, volvemos a entrenar sin coste adicional.
Auditoría de IA gratuita
Contáctanos antes de ordenar para una auditoría gratuita de 15 minutos del dataset y recomendación de arquitectura del modelo.
Senior Software Engineer
Level 2
Idiomas
Traducción automática
Traducción automática
¿Por qué debo enviarle un mensaje antes de ordenar?
Hablar antes nos permite evaluar el tamaño de tu dataset, verificar la compatibilidad con el modelo base (por ejemplo, Llama 3, Mistral) y confirmar los requisitos de computación para ofrecerte el paquete adecuado.
¿Qué arquitecturas de LLM base soportas para ajuste fino?
Soportamos Llama 3/3.1, Mistral, Mixtral, Gemma 2, Qwen 2.5, DeepSeek, Falcon y cualquier modelo de pesos abiertos personalizado alojado en Hugging Face.
¿Cuál es la diferencia entre LoRA y QLoRA?
LoRA entrena matrices adaptadoras de bajo rango para adaptar un modelo de manera eficiente. QLoRA cuantiza el modelo base a 4 bits durante el entrenamiento, reduciendo drásticamente los requisitos de VRAM en GPU y manteniendo la precisión máxima del modelo.
¿Quién cubre los costos de computación en GPU y la infraestructura en la nube?
Los costos de computación (RunPod, Lambda Labs, Google Colab Pro o Hugging Face Inference Endpoints) los paga directamente el cliente. Te guiamos para configurar la GPU más rentable.
¿En qué formato debo proporcionar mi dataset?
Puedes enviar tus datos en JSON, JSONL, CSV o texto sin formato. Los limpiamos, validamos y convertimos en formatos de instrucciones estándar como Alpaca, ShareGPT o ChatML.
¿Qué entregables exactos recibiré al finalizar el proyecto?
Recibirás pesos entrenados del adaptador LoRA, el modelo independiente fusionado (si lo solicitas), archivos GGUF cuantizados para Ollama/LM Studio, scripts de prueba y métricas de evaluación.
¿Puedes desplegar el modelo ajustado a una API o nube privada?
Sí. Podemos desplegar tu modelo entrenado en Hugging Face Dedicated Endpoints, RunPod sin servidor, vLLM, Ollama o en un backend FastAPI personalizado en AWS/GCP.
¿Qué acceso a API o plataformas de terceros necesitarás?
Podemos necesitar acceso de lectura/escritura a tu cuenta de Hugging Face (token de acceso) y a tu plataforma de GPU en la nube (RunPod, Lambda Labs o AWS) mediante claves API o credenciales temporales.
¿Cómo manejas las revisiones y el rendimiento de benchmark?
Cada nivel incluye revisiones para ajustar tasas de aprendizaje, épocas o parámetros rank/alpha. Evaluamos tu modelo con conjuntos de validación para verificar la calidad.
¿Ofrecen soporte y mantenimiento post-entrega?
Sí, ofrecemos mantenimiento continuo y soporte de retainer para ingesta periódica de datasets, retraining de modelos y escalado de inferencia en la nube.