Explorar las categorías
Explora
Fiverr Pro
Español
$
USD

Traducción automática
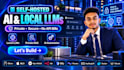
¿Quieres ejecutar IA en tu propio hardware, de forma privada, segura y sin facturas mensuales de API?
¡Estás en el lugar correcto!
Configuro llms autohospedados y herramientas de IA de código abierto en tu Mac Studio, clúster de Mac, servidor GPU o en máquinas locales, completamente privado y listo para usar.
Lo que ofrezco:
Pila tecnológica:
Entornos de ejecución de LLM: Ollama || llama.cpp || MLX || vLLM || LM Studio || exo
Aplicaciones de código abierto: Open WebUI || n8n || Dify || Flowise || AnythingLLM || LocalAI
Hardware: Mac Studio || Mac Mini || Servidores GPU NVIDIA || En local
Herramientas: Docker || Linux || Tailscale || Nginx
¿Por qué elegirme?
¡Vamos a ejecutar tu propia IA hoy!
Senior Software Engineer POS, ERP and AI Powered Web Mobile Solutions
Idiomas
Traducción automática
Traducción automática
¿Qué hardware necesito para ejecutar un LLM local?
Los modelos pequeños (7B a 8B) funcionan bien en un Mac con más de 16GB de RAM o en un GPU con más de 8GB de VRAM. Los modelos más grandes (70B+) necesitan un Mac Studio con más de 64GB o un servidor GPU con alta VRAM. Recomendaré el modelo adecuado para tu hardware.
¿Puedes configurar LLMs en un Mac Studio o Mac Mini?
Sí. Los Macs con Apple Silicon son excelentes para IA local gracias a la memoria unificada. Uso MLX, Ollama y llama.cpp para obtener la mejor velocidad en chips M-series.
¿Qué es un clúster de Mac y necesito uno?
Un clúster de Mac conecta varios Macs para ejecutar modelos demasiado grandes para una sola máquina, como modelos de más de 400B de parámetros. Usando herramientas como exo y MLX, combinan su memoria para que funcionen como un sistema de IA único.
¿Qué es Open WebUI?
Open WebUI es una interfaz privada estilo ChatGPT para tus LLMs locales. Tu equipo puede chatear, subir documentos y gestionar conversaciones, todo en tu propio hardware con cuentas de usuario y permisos.
¿Puedes autohospedar n8n para automatización de IA?
Sí. Configuro n8n en tu servidor y lo conecto a tu LLM local, para que puedas automatizar correos, documentos y flujos de trabajo con IA sin pagar por tarea ni compartir datos.
¿Mis datos son realmente privados?
Sí. Todo funciona en tus propias máquinas, por lo que los prompts, documentos y datos nunca salen de tu red ni van a OpenAI, Google o terceros.
¿Puedo acceder a mi IA local de forma remota?
Sí. Puedo configurar acceso remoto seguro con Tailscale, VPN o Nginx con SSL, para que tú y tu equipo puedan usarlo desde cualquier lugar de forma segura.
¿Un LLM local será tan bueno como ChatGPT?
Modelos open-source modernos como Llama, Qwen y DeepSeek funcionan muy bien para la mayoría de tareas empresariales. Te ayudaré a elegir el mejor modelo para tus necesidades y hardware.
¿Cómo accedo a mi máquina para la configuración?
A través de acceso remoto seguro que apruebes, como SSH, AnyDesk o una sesión de compartir pantalla. Nunca necesito tus contraseñas personales y puedes revocar el acceso cuando terminemos.
¿No estás seguro de qué paquete se ajusta a tu configuración?
Envíame un mensaje antes de ordenar con los detalles de tu hardware. Recomendaré el paquete adecuado o te enviaré una oferta personalizada.
