Explorar las categorías
Español
$
USD
Conecta tu IA a Fiverr
Ingeniero de software senior en POS, ERP y soluciones web y móviles con IA
¿Necesitas que tu LLM se implemente en producción, de manera rápida, optimizada y rentable?
¡Estás en el lugar correcto!
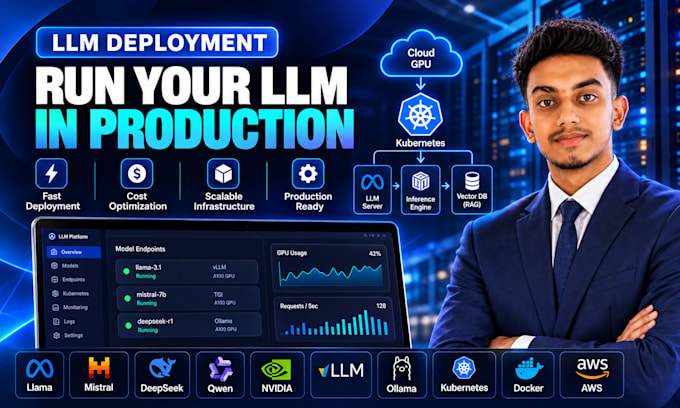
Despliego y configuro open-source LLMs en servidores GPU en la nube y Kubernetes, con motores de inferencia ajustados para respuestas rápidas y costos menores de GPU.
Lo que ofrezco:
Pila tecnológica:
Inferencia: vLLM || TGI || Ollama || NVIDIA Triton || TensorRT-LLM || llama.cpp || SGLang
Modelos: Hugging Face || Llama || Mistral || Qwen || DeepSeek
Nube y GPU: AWS || Google Cloud || Azure || RunPod || Lambda Labs
Contenedores: Docker || Kubernetes || Helm
Monitoreo: Prometheus || Grafana
¿Por qué elegirme?
¡Hagamos que tu LLM esté en línea hoy mismo!
Traducción automática
¿Qué LLMs puedes desplegar?
Cualquier modelo open-source de Hugging Face, incluyendo Llama, Mistral, Qwen, DeepSeek, Gemma y Phi, así como modelos ajustados o personalizados que proporciones.
¿Qué incluye la configuración del motor de inferencia?
Configuro y ajusto vLLM, TGI, Triton o Ollama para tu modelo: memoria GPU, batching, longitud de contexto, caché KV, paralelismo tensorial y cuantización, para respuestas más rápidas y menor costo.
¿Qué motor de inferencia debería usar?
vLLM para APIs de alto rendimiento, TGI para modelos de Hugging Face, Triton o TensorRT-LLM para máximo rendimiento en GPU NVIDIA, y Ollama o llama.cpp para setups más pequeños o en CPU. Recomendaré la mejor opción.
¿Puedes reducir mis costos de GPU?
Sí. A través de cuantización (AWQ, GPTQ, GGUF), batching y dimensionamiento adecuado de GPUs, puedo ejecutar el mismo modelo en hardware más barato con calidad similar.
¿Funcionará la API como la de OpenAI?
Sí. Puedo configurar un endpoint API compatible con OpenAI, para que puedas cambiar tu app actual de OpenAI a tu propio LLM simplemente cambiando la URL base y la clave API.
¿Quién paga los costos de GPU y nube?
Los costos de GPU y hosting los factura el proveedor (AWS, GCP, Azure, RunPod, etc.) a tu propia cuenta. Te ayudaré a elegir la GPU más rentable para tu modelo y tráfico.
¿Mi modelo y datos son privados?
Sí. Tu LLM corre en tus propios servidores, por lo que los prompts y datos nunca van a APIs de terceros. También aseguro el endpoint con claves API, SSL y reglas de firewall. Puedo firmar un NDA si es necesario.
¿Qué necesito proporcionar antes de comenzar?
El modelo que deseas (o tus requisitos), acceso a tu cuenta en la nube o GPU, tráfico esperado y cualquier dominio que quieras usar. Si no estás seguro, ofrezco una consulta gratuita.
¿Puedes desplegar un modelo que ajusté?
Sí. Comparte tus pesos del modelo o el repositorio en Hugging Face, y lo desplegaré y optimizaré con el motor de inferencia adecuado.
¿No estás seguro de qué paquete se ajusta a tu proyecto?
Envíame un mensaje antes de ordenar. Revisaré tus necesidades de modelo y tráfico y recomendaré el paquete adecuado o te enviaré una oferta personalizada.
