Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
Ingeniero de IA: afinación de LLM con LoRA y QLoRA
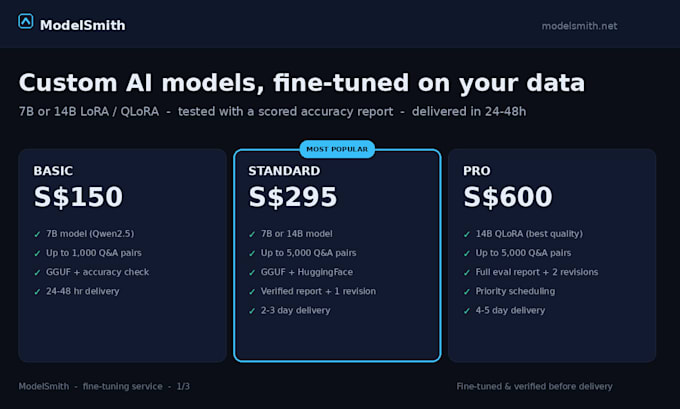
Afinaré modelos de IA 7B y 14B con tus datos. No plantillas de prompts: son LLMs reales, afinados, entrenados con tus preguntas y respuestas, probados antes de la entrega y enviados en el formato que necesites.
Lo que hago:
- Afinación LoRA / QLoRA de modelos 7B o 14B (Qwen2.5 por defecto)
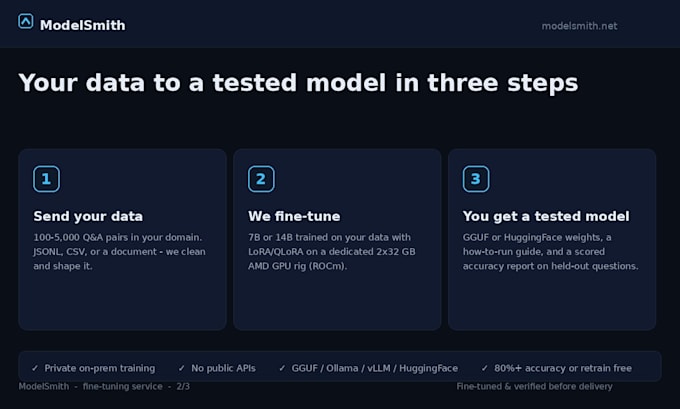
- Entrenados con 100 a 5,000 pares de tus propias preguntas y respuestas
- Verificados con un informe de precisión puntuado en preguntas retenidas
- Entregados como GGUF (Ollama, llama.cpp) o HuggingFace (vLLM, Transformers)
Por qué es diferente:
La mayoría de gigs de afinación te entregan un archivo y te dicen buena suerte. Yo lo pruebo primero. Cada modelo viene con un informe de precisión sobre tus datos retenidos: 80% o más, o vuelvo a entrenarlo gratis.
Privacidad:
El entrenamiento se realiza en un rig privado de 2x32 GB de GPU. Tus datos nunca van a una API pública y se eliminan al entregar a menos que me pidas guardarlos.
Velocidad:
Un LoRA de 7B se entrena en menos de una hora de cómputo. La mayoría de proyectos se entregan en 24 a 48 horas.
Envíame tu dataset y tendrás un modelo probado en cuestión de días.


Lenguaje de programación:
Python
•
Pytorch
•
Otros
Marcos y herramientas de modelos de IA:
Tipo de datos:
Texto
•
Datos tabulares
•
Otros
Motor de IA:
Llama
•
PyTorch
•
Otros
Traducción automática
¿Que modelo utilizas?
Qwen2.5-7B-Instruct por defecto para el nivel 7B. Qwen2.5-14B-Instruct para 14B. Modelos Mistral y Llama disponibles a petición.
¿Qué necesito para enviarte?
100 a 5,000 pares de Q y A en cualquier formato: JSONL, CSV o incluso un documento. Limpiaré y estructuraré todo.
¿En qué se diferencia esto de una plantilla de prompt o prompt de sistema?
Una plantilla de prompt instruye a un modelo genérico. Afinar cambia los pesos del modelo para que conozca tus respuestas de forma nativa. Mayor precisión, tu voz, menor sobrecarga de prompts.
¿Mis datos están seguros?
Sí. El entrenamiento se realiza en un rig local privado de 2x32 GB, no en una API pública. El dataset se elimina al entregar a menos que me pidas conservarlo.
¿Qué recibo exactamente?
Pesos del modelo (GGUF y/o HuggingFace), una guía de ejecución con comandos exactos para tu entorno (Ollama, llama.cpp, vLLM) y un informe de precisión puntuado.
¿Qué pasa si el modelo no funciona bien?
La opción estándar incluye 1 revisión gratuita, Premium 2. Si la evaluación con los datos retenidos no alcanza tu objetivo de precisión, vuelvo a entrenarlo sin costo.
¿Cuánto tarda la entrega?
7B: 24-48 horas. 14B: 2-5 días. El plazo empieza cuando se confirma tu dataset.
¿Necesito mi propia GPU o hardware?
No. Yo me encargo del entrenamiento en mi equipo. Solo necesitas hardware para correr el modelo final (cualquier CPU puede ejecutar un 7B GGUF, o usar Ollama).