Explorar las categorías
Explora
Fiverr Pro
Español
$
USD


Traducción automática
¿Estás cansado de tutoriales genéricos y datos desordenados que no resuelven tu problema real? ¿Necesitas un modelo personalizado de Machine Learning o Deep Learning que esté rigurosamente validado?
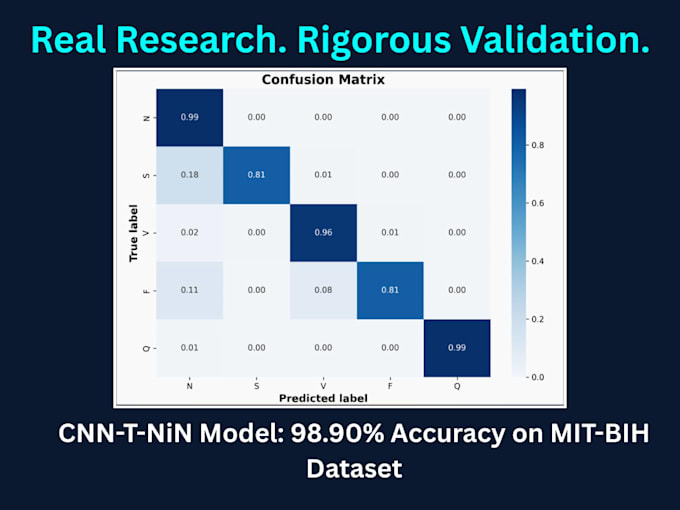
Soy investigador en IA con una maestría en Ciencias de la Computación (IA) por la Universidad COMSATS. Mi investigación publicada se centra en deep learning para la clasificación de señales de ECG, y he desarrollado un asistente de trading con IA que mejora por sí mismo y funciona en producción.
Me especializo en construir arquitecturas personalizadas de Deep Learning (CNNs, Transformers) en PyTorch, Machine Learning tabular (Random Forest, XGBoost) con ajuste mediante Optuna, y protocolos de validación rigurosos (validación cruzada a nivel de paciente en 5 pliegues, LOSO, walk-forward).
No solo entreno modelos; los valido rigurosamente con validación cruzada y reportes honestos, asegurando que tu solución funcione de manera confiable en el mundo real.
Mis servicios incluyen:
Por favor, envíame un mensaje antes de ordenar para que podamos discutir tu conjunto de datos, objetivos y desafíos. Construyamos algo que funcione.
AI and Machine Learning Expert, Python Automation
Idiomas
Traducción automática
Traducción automática
¿Qué herramientas y marcos utilizas?
Principalmente uso PyTorch para deep learning, y Scikit-Learn, XGBoost y Pandas para datos tabulares y preprocesamiento. También uso Optuna para ajuste de hiperparámetros y SHAP para explicabilidad.
¿Qué necesitas de mí para empezar?
Necesito tu conjunto de datos (CSV, Excel o acceso a base de datos), una descripción clara de tu objetivo (por ejemplo, clasificación, regresión, series temporales) y la variable objetivo que deseas predecir.
¿Realizas preprocesamiento de datos?
Sí. El preprocesamiento estándar (manejo de valores faltantes, normalización, cambio de forma y manejo del desequilibrio de clases) está incluido en los paquetes Standard y Premium.
¿Proporcionas documentación y código fuente?
Los paquetes Standard y Premium incluyen código fuente completo, comentarios en el código y un informe detallado de rendimiento. Si necesitas documentación adicional en el paquete Basic, puedes seleccionarla como extra en el gig.