Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
Ingeniero de datos
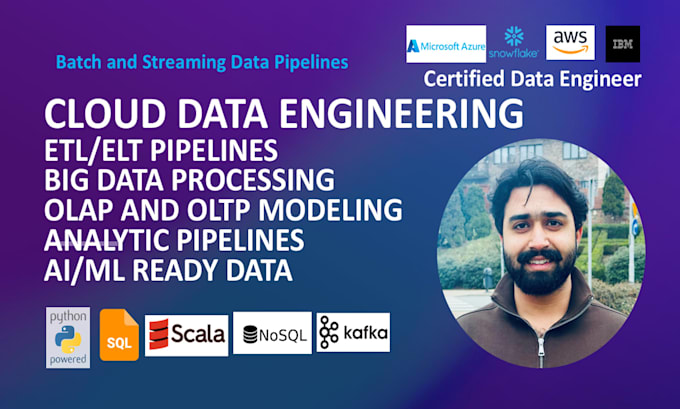
¿Necesitas un ingeniero de datos senior para pipelines ETL/ELT escalables, procesamiento de Big Data, Data Warehousing o arquitecturas Lakehouse?
Soy Muhammad Ahmed, un ingeniero de datos con más de 4 años de experiencia construyendo plataformas de datos de nivel empresarial en ecosistemas de AWS, Azure, GCP y Snowflake.
Servicios que ofrezco:
Tecnologías:
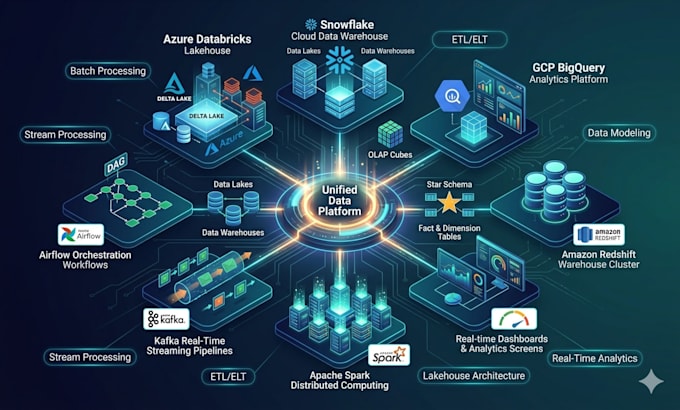
Azure Databricks, Snowflake, GCP BigQuery, Amazon Redshift, Apache Spark, PySpark, Kafka, Airflow, DBT, Snowflake SQL, SparkDF, PostgreSQL, AWS, Docker, Python, SQL.
Construyo soluciones de ingeniería de datos escalables, confiables y nativas en la nube para análisis, informes, automatización y procesamiento en tiempo real. Además, proporciono datos listos para IA/ML y análisis.
Ingeniería de datos, ETL, ELT, Big Data, PySpark, Airflow, Kafka, Snowflake, Databricks, Data Warehouse, Redshift, BigQuery.
Plataforma de almacenes:
Snowflake
•
BigQuery
•
Databricks
Tipo de proyecto:
Nueva creación
Traducción automática
¿Qué plataformas en la nube soportan?
Trabajo con AWS, Azure, GCP, Snowflake, Databricks, Amazon Redshift y BigQuery.
¿Construyes pipelines por lotes y en streaming?
Sí. Desarrollo pipelines por lotes usando Apache Spark y soluciones en streaming con Kafka y Spark Streaming.
¿Puedes diseñar arquitecturas de Data Warehouse y Lakehouse?
Sí. Diseño Data Lakes, Data Warehouses y sistemas Lakehouse escalables usando Medallion Architecture y plataformas modernas en la nube.
¿Qué herramientas de orquestación utilizas?
Apache Airflow, tareas y trabajos programados en Snowflake, y soluciones de programación nativas en la nube.
¿Implementas modelado de datos?
Sí. Trabajo con esquema estrella, snowflake, dimensiones, tablas de hechos, modelado OLAP y OLTP.
¿Qué tecnologías utilizas para el procesamiento de datos?
PySpark, Spark SQL, DBT, Snowflake SQL, SparkDF, Python, SQL, Kafka y herramientas de procesamiento nativas en la nube.
¿Puedes optimizar pipelines existentes?
Sí. Puedo mejorar el rendimiento, la escalabilidad, la optimización de costos y la confiabilidad de sistemas de ingeniería de datos existentes.