Explorar las categorías
Español
$
USD
Conecta tu IA a Fiverr

Traducción automática
¿Necesitas un modelo de machine learning entrenado con tus datos, con resultados honestos y claros?
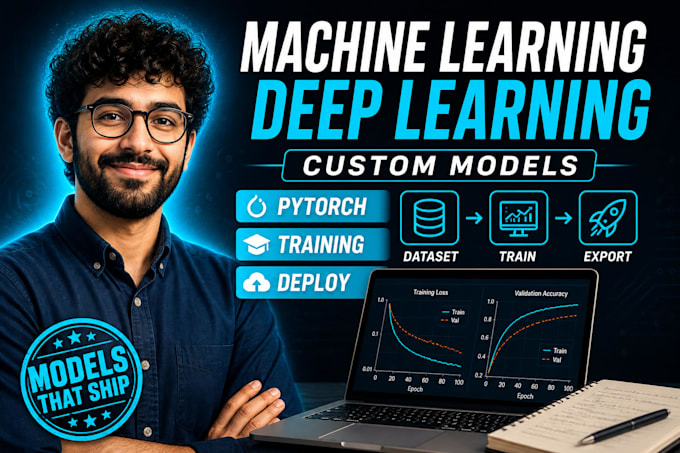
Entreno modelos de ML y deep learning en Python con scikit-learn, XGBoost, PyTorch y TensorFlow, para tareas de clasificación, regresión, texto e imagen.
¿Eres nuevo aquí? Comienza con el paquete Basic: un modelo en tu conjunto de datos limpio con métricas de evaluación y un cuaderno de Jupyter, entregado en 3 días. Es un primer proyecto simple y de bajo riesgo.
Lo que obtienes:
- Definición del problema: qué predecir y cómo medirlo
- Un modelo base, luego uno más fuerte donde sea útil
- División adecuada de entrenamiento y prueba para que los resultados no estén inflados
- Métricas claras como precisión, F1, RMSE o una matriz de confusión
- Un cuaderno limpio con comentarios que puedes volver a ejecutar
- Un archivo del modelo guardado y un script de predicción (Standard y Premium)
El paquete Standard añade limpieza de datos, trabajo con características y comparación de modelos. El Premium añade deep learning o un script de predicción listo para desplegar o una pequeña API.
Así funciona:
1. Envía tu conjunto de datos y dime qué quieres predecir
2. Reviso los datos y confirmo el plan antes de comenzar
3. Recibes el cuaderno, el modelo y un resumen breve de los resultados
Te diré honestamente si tus datos son demasiado pequeños o ruidosos para el resultado que deseas.
AI Engineer, RAG, ML and Agents
Idiomas
Traducción automática
Traducción automática
¿Qué es un conjunto de datos limpio para el paquete básico de 30$?
Una tabla (CSV o Excel) con una columna de destino clara, sin datos faltantes importantes y hasta aproximadamente 100k filas. Si tus datos necesitan limpieza, fusión o etiquetado, el estándar es la mejor opción.
¿Puedes garantizar una precisión específica?
No. Los resultados dependen de tus datos. Te daré métricas honestas sobre los datos de prueba reservados, explicaré qué limita la puntuación y sugeriré cómo mejorarla.
¿Qué herramientas y marcos utilizas?
Python con Pandas, scikit-learn y XGBoost para datos tabulares, y PyTorch o TensorFlow para deep learning, texto e imágenes. Si necesitas una biblioteca específica, dímelo antes de hacer el pedido.
¿Haces visión por computadora o NLP?
Sí, por ejemplo clasificación de imágenes o clasificación de texto y análisis de sentimientos. Estos suelen encajar en Standard o Premium porque requieren más preparación de datos y tiempo de entrenamiento.
¿Qué recibiré al final?
Un cuaderno Jupyter, el archivo del modelo entrenado, métricas y un resumen breve en inglés sencillo. Premium puede incluir un script de predicción o una pequeña API para que puedas usar el modelo en tu app.
