Explorar las categorías
Español
$
USD
Conéctate con tu IA
Análisis de datos de AbyssalAnalytics por un biólogo compañero
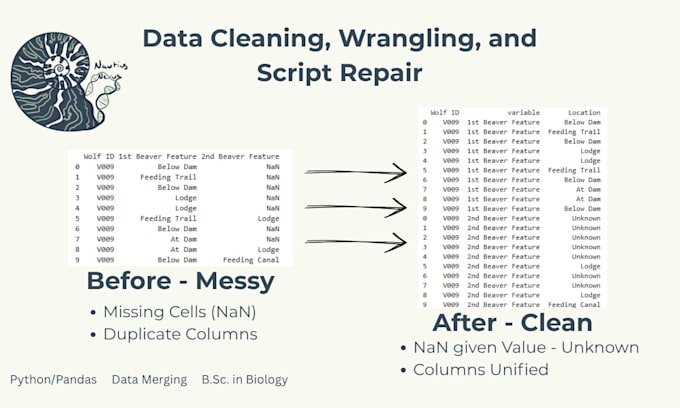
¿Eres un estudiante de posgrado, investigador o académico que lucha con código roto o un conjunto de datos desordenado? Como analista de datos con una licenciatura en biología y una minor en ciencias psicológicas, entiendo que tus datos representan horas de observaciones meticulosas y trabajo físico, y no son solo hojas de cálculo corporativas. Me especializo en la ejecución mecánica de la limpieza de datos para que puedas concentrarte por completo en tu tesis, las guías del comité u otros asuntos apremiantes.
Lo que hago:
Depuración de código: eliminar errores de sintaxis, bucles o advertencias de diseño en tus cuadernos de Jupyter.
Wrangling de datos: reestructurar formatos crudos, manejar celdas ausentes y normalizar categorías de texto.
Integración multi-flujo: sincronizar hasta 3 registros o hojas de cálculo separadas en un conjunto de datos unificado.
Nota: para proteger la integridad de los datos, tu archivo en bruto y las hipótesis de investigación quedan congelados una vez que comienza el pedido.
Para conjuntos de datos masivos que superen los umbrales de filas, por favor añade el extra 'Extra Data or File' al hacer el checkout. Para una notebook de proyecto adicional, selecciona el mismo. Si quieres una explicación del código, elige 'Code Documentation'.
Revisa mi código público en github.com/skyegambrel
Traducción automática
¿Qué formatos de archivo específicos aceptas para la limpieza de datos?
Acepto formatos de datos tabulares estándar, incluidos CSV, XLSX (Excel), TSV y archivos TXT, así como archivos de cuadernos Jupyter (.ipynb) para depuración. Asegúrate de que las estructuras de tus archivos no estén cifradas antes de subirlas al panel de requisitos.
¿Qué cuenta como una sola “Item Cleaned” o archivo de dataset?
Una sola ítem se refiere a una hoja de cálculo independiente, una tabla de datos o un cuaderno de código fuente. El Nivel 1 cubre un solo archivo de script roto, el Nivel 2 un único archivo de datos crudo (hasta 200 filas) y el Nivel 3 la limpieza e integración estructural de hasta 3 archivos separados.
¿Cómo manejas valores faltantes, celdas en blanco o NaN en mi conjunto de datos?
• Utilizo bibliotecas de Python especializadas (Pandas y NumPy) para aislar patrones de datos ausentes. Según tus instrucciones, crearé pipelines limpios para eliminar filas vacías, aislar lagunas estructurales o imputar categorías faltantes según los requisitos de tu proyecto, sin fabricaciones.
¿Explicarás el código de Python o las bibliotecas que usaste para limpiar mis archivos?
Las rutas base entregan el archivo de datos limpio y tu script anotado. Si necesitas una explicación detallada, palabra por palabra en inglés sencillo de las funciones exactas de Pandas usadas para que puedas defender fácilmente la tubería de datos ante tu comité, selecciona el extra 'Code Documentation' al checkout.
¿Firmas Acuerdos de Confidencialidad (NDAs) o cláusulas de privacidad de datos?
Según las estrictas reglas de confidencialidad de la plataforma de Fiverr, tus archivos fuente, notas de observación y hipótesis se tratan como propiedad intelectual confidencial y no se comparten ni publican.
