Explorar las categorías
Español
$
USD
Conecta tu IA a Fiverr
Estadístico y científico de datos, R Studio, Python y aprendizaje automático.
¿Necesitas que tus datos sean recolectados, limpiados, explorados o analizados? Convierto sitios web, APIs y archivos desordenados en conjuntos de datos listos para analizar y en ideas accionables.
Soy estadístico y científico de datos con más de 7 años de experiencia en R, Python y análisis de investigación.
Servicios (adaptados a tu proyecto):
Las herramientas incluyen Pandas, NumPy, tidyverse, scikit-learn, RStudio y SQL.
Los paquetes cubren una consultoría, auditoría de datos o piloto con alcance; pipelines completos, modelos avanzados y scraping recurrente se cotizan mediante ofertas personalizadas.
Envíame un mensaje primero con tus fuentes, datos de muestra, objetivos y entregables deseados. Solo datos autorizados y permitidos.
Traducción automática
¿Puedes recolectar datos de sitios web, APIs, PDFs o bases de datos?
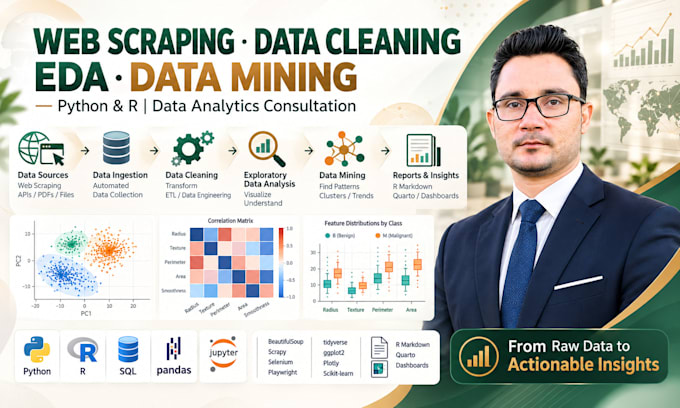
Sí. Evalúo sitios públicos, APIs permitidas, archivos descargables, PDFs y bases de datos para extracción. Se cotizan, tras revisar el acceso, las reglas de la fuente y los requisitos de datos, tareas como crawling, paginación, recopilación programada y trabajos de mayor tamaño.
¿Qué herramientas de scraping y extracción utilizas?
Dependiendo de la fuente: Python Requests, BeautifulSoup, Scrapy, Selenium, Playwright, APIs, además de R rvest y httr2. Puedo exportar datos estructurados en CSV, Excel, JSON o listos para base de datos. Sólo se admite acceso autorizado y permitido.
¿Puedes construir pipelines SQL, ETL/ELT y de ingeniería de datos?
Sí, para alcances acordados: uniones, transformaciones, ingestión de datos, validación, consultas SQL y scripts ETL/ELT reproducibles. PostgreSQL, MySQL, SQLite, Pandas, dbt, Airflow, Spark o almacenes en la nube pueden discutirse si son adecuadas.
¿Puedes limpiar, fusionar y preprocesar conjuntos de datos desordenados?
Sí. Manejo valores faltantes, duplicados, formatos inconsistentes, tipos de datos, valores atípicos, fusiones, reestructuración, codificación, normalización y controles de calidad usando Pandas, NumPy, tidyverse o SQL. El mejor enfoque depende del conjunto de datos.
¿Qué incluye el análisis exploratorio de datos (EDA)?
La EDA puede incluir estadísticas descriptivas, distribuciones, tendencias, correlaciones, mapas de calor, boxplots, gráficos Q-Q, matrices de dispersión, verificación de atípicos e interpretación con R, Python, ggplot2, seaborn, Matplotlib o Plotly.
¿Puedes aplicar técnicas de minería de datos, IA y aprendizaje automático?
Dependiendo del alcance: segmentación, K-means, DBSCAN, reglas de asociación, detección de anomalías, PCA, minería de texto/NLP, regresión, clasificación y predicción. Modelos avanzados, ajuste extenso y despliegue requieren una cotización personalizada separada.
¿Qué software, herramientas de programación y paquetes soportas?
Herramientas centrales: R/RStudio, Positron, Python, Jupyter, SQL, Excel, Pandas, NumPy, tidyverse, dplyr, ggplot2, scikit-learn y Quarto. SPSS, Stata, MATLAB, Power BI, Tableau, Shiny o Streamlit pueden discutirse por proyecto.
¿Recibiré datos limpios, código, gráficos, tableros o informes?
Los entregables pueden incluir CSV, Excel, JSON, SQL/Parquet, scripts en R/Python, cuadernos, informes reproducibles, tablas estadísticas, visualizaciones y dashboards. Los archivos exactos, código fuente, hosting y la profundidad del informe dependen de tu alcance personalizado.
¿Por qué ofreces paquetes de alcance y pedidos personalizados?
Las fuentes de datos, el volumen, las restricciones de acceso y los métodos varían mucho. El básico cubre un alcance/viabilidad de pago, Standard una auditoría y Premium un piloto limitado. Scraping completo, pipelines ETL, proyectos de ML, dashboards y trabajo continuo usan ofertas personalizadas.
¿Qué debo proporcionar y qué solicitudes de extracción quedan excluidas?
Envía URLs de origen o archivos de muestra, detalles de acceso autorizado, campos necesarios, volumen aproximado, preguntas, formato de salida y fecha límite. No puedo omitir controles de acceso, rastrear perfiles sociales privados ni recolectar datos personales sin permiso.
| (1) | ||
| (0) | ||
| (0) | ||
| (0) | ||
| (0) |
ahil38

Pakistán
I had an outstanding experience working with Abdul Wadud on a complex dataset. Their thorough analysis and insightful visualizations through R Markdown provided meaningful insights, and their tailored approach and professionalism made the project a true success. Will absolutely come again and will recommend him.
USD 50
$
1 día
Tiempo
| (1) | ||
| (0) | ||
| (0) | ||
| (0) | ||
| (0) |
ahil38
Pakistán
I had an outstanding experience working with Abdul Wadud on a complex dataset. Their thorough analysis and insightful visualizations through R Markdown provided meaningful insights, and their tailored approach and professionalism made the project a true success. Will absolutely come again and will recommend him.
USD 50
$
1 día
Tiempo