Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
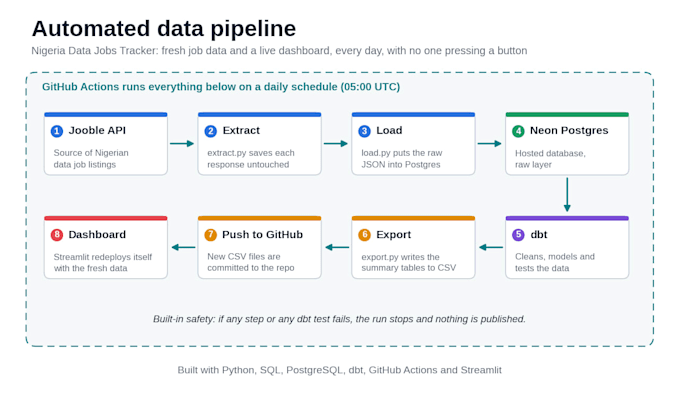
¿Necesitas que tus datos se recojan, limpien y se mantengan actualizados automáticamente? Construyo pipelines de datos que funcionan por sí solos, para que siempre cuentes con datos frescos y confiables.
QUÉ CONSTRUYO
- Extracción de APIs y archivos con Python
- Carga en PostgreSQL
- Limpieza y modelado con dbt, con pruebas de calidad de datos
- Automatización diaria con GitHub Actions, sin necesidad de servidor
- Un panel en vivo de Streamlit al que puedes acceder con un enlace y también a cualquier destino final que elijas
PRUEBAS DE FUNCIONAMIENTO
He creado y gestionado Nigeria Data Jobs Tracker: extrae listados de empleo cada día, los limpia con dbt y actualiza un panel público automáticamente.
Demostración en vivo: nigeria-job-market-tracker-c2dqzraz9ouopa9qo4cgnt.streamlit.app
CÓMO TRABAJO
- Tú me dices tu fuente de datos y qué quieres ver
- Construyo el pipeline y entrego el código
- Las pruebas corren en cada actualización, para que los datos malos se detecten antes de llegar a tu panel
Herramientas: Python, SQL, PostgreSQL, dbt, GitHub Actions, Streamlit, Docker.
Envíame un mensaje antes de pedir con una breve descripción de tus datos y te recomendaré el paquete adecuado.
Traducción automática
¿Qué necesitas de mí para empezar?
La fuente de datos (una API, archivos o una base de datos), qué quieres medir y dónde deben terminar los datos.
¿Puede la canalización ejecutarse automáticamente todos los días?
Sí. El paquete Premium incluye una programación diaria con GitHub Actions, por lo que se ejecuta sin que nadie lo inicie.
¿Obtengo el código fuente?
Sí, todos los paquetes incluyen el código fuente completo.