Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
Ingeniero de datos
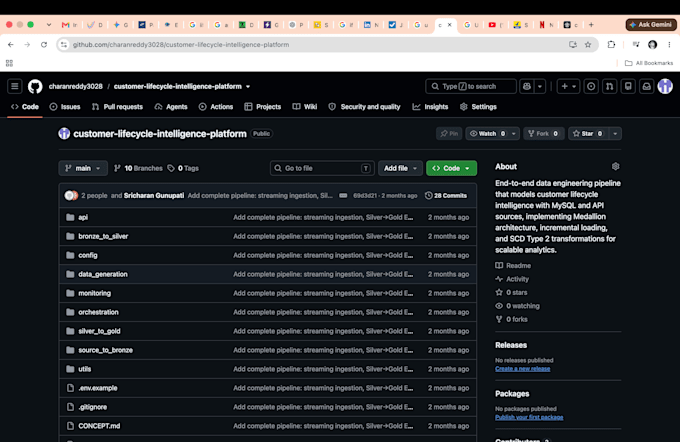
Construiré pipelines de datos confiables y eficientes usando Python, SQL, PySpark y flujos de trabajo ETL modernos.
Ya sea que tengas datos en CSV, Excel, JSON, API o bases de datos, puedo ayudarte a extraer, limpiar, transformar, validar y preparar los datos para análisis, informes o aplicaciones downstream.
Mis servicios incluyen:
Procesamiento y automatización de datos con Python
Consultas SQL y transformación de datos
Desarrollo de pipelines ETL
Procesamiento de datos con PySpark
Limpieza y validación de datos
Extracción de datos mediante API y archivos
Integración de datos de base de datos a base de datos
Transformación de datos y automatización de flujos de trabajo
Documentación básica de pipelines
Me enfoco en escribir código limpio, mantenible y eficiente, adaptado a tus necesidades.
Si tienes una tarea pequeña de datos, un flujo de trabajo ETL o un requerimiento mayor de pipeline de datos, no dudes en enviarme un mensaje con tus requisitos antes de hacer un pedido. Revisaré tu proyecto y te sugeriré el enfoque más adecuado.
Plataforma de almacenes:
BigQuery
Tipo de proyecto:
Optimización
