Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
Desarrollador de automatización de scraping web con Python
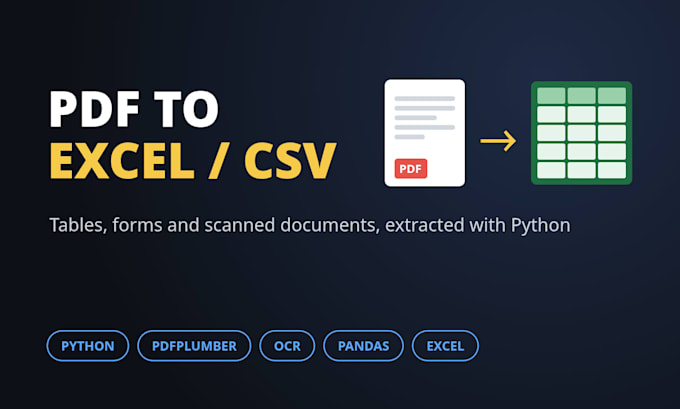
¿Te quedaste atascado copiando datos de PDFs a mano? Los extraeré con Python a un archivo Excel o CSV limpio, listo para filtrar y analizar.
Lo que puedo extraer:
- Tablas de informes, facturas, estados bancarios y listas de precios, incluso cuando abarcan varias páginas
- Formularios rellenables: cada campo, casilla y desplegable, una fila por formulario
- Texto de documentos escaneados con OCR (Tesseract), con valores de baja confianza revisados manualmente
- Salida solo de texto (.txt) en el orden de lectura correcto, si eso es lo que necesitas
Cómo trabajo:
- Envíame 1-2 archivos de muestra antes de ordenar y confirmaré si es posible
- Después de que hagas el pedido, te devolveré las primeras páginas para aprobación antes de procesar todo el lote
- Los números y fechas se almacenan como números y fechas reales, no como texto
- Verifico el conteo de filas y totales con la fuente, para que no falte nada
Pila: Python, pdfplumber, PyMuPDF, pypdf, Tesseract OCR, Pandas, openpyxl.
En Standard y Premium también obtienes el script, para que los archivos del próximo mes sean con un clic.
Los documentos manuscritos no son algo que pueda hacer de manera confiable, así que por favor envíame un mensaje primero si los tuyos son manuscritos.
Tecnología:
Python
•
Excel
•
Pandas
Tipo de información:
Otros
Técnica:
Automatizado
Traducción automática
¿Puedes extraer datos de PDFs escaneados?
Sí, con OCR. La precisión depende de la calidad del escaneo, así que envíame una muestra primero y te diré qué esperar.
Mis PDFs tienen diferentes diseños. ¿Es eso un problema?
No. Cada diseño tiene sus propias reglas de análisis. El paquete indica cuántos diseños están incluidos, y se pueden agregar diseños adicionales.
¿Mis datos se mantienen privados?
Sí. Tus archivos se usan solo para tu pedido y se eliminan después de la entrega.
