Explorar las categorías
Español
$
USD
Conéctate con tu IA
¿Luchas con datos desordenados o sin organizar? Unos datos limpios son esenciales para tomar decisiones empresariales fiables y modelos predictivos precisos.
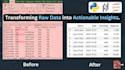
Como científico de datos en Python, transformo conjuntos de datos crudos en datos limpios, estructurados y con ideas accionables.
Qué ofrezco: Limpieza de datos: manejar valores faltantes, eliminar duplicados, corregir tipos de datos e identificar valores atípicos. Transformación de datos: fusionar archivos, reformatear conjuntos de datos y organizar características. Análisis exploratorio de datos (EDA): descubrir tendencias, patrones y anomalías. Visualización de datos: crear gráficos perspicaces, histogramas, gráficos de dispersión y mapas de calor.
Herramientas y tecnologías: Python, Pandas, NumPy, Matplotlib, Seaborn, SciPy, Jupyter Notebook, MongoDB, SQL, DuckDB y JSON.
¿Por qué elegirme? código limpio, profesional y bien documentado. Entrega rápida y actualizaciones de progreso regulares. Enfoque en precisión de datos, privacidad y seguridad.
Ya sea que necesites limpieza básica de datos o un análisis en profundidad, estoy listo para ayudarte a convertir tus datos en insights valiosos.
Envíame un mensaje antes de hacer un pedido para discutir tu conjunto de datos, formato de archivo, requisitos y objetivos del proyecto. ¡Hagamos que tu análisis de datos esté listo para usar!



Traducción automática
¿Qué librerías de Python utilizas para limpieza de datos y EDA?
Principalmente uso Pandas y NumPy para manipulación y limpieza eficientes de datos. Para análisis exploratorio y visualización, utilizo Matplotlib, Seaborn y Plotly para generar gráficos claros e perspicaces.
¿Qué formatos de archivos de datos puedes manejar?
Puedo trabajar con casi cualquier formato de datos estándar, incluyendo CSV, Excel (.xlsx, .xls), JSON, bases de datos SQL, TXT y archivos Parquet.
¿Qué incluye tu proceso de “Limpieza de datos”?
El proceso de limpieza suele incluir manejo de valores faltantes o nulos, eliminación de registros duplicados, corrección de formatos de datos inconsistentes, corrección de tipos de datos, filtrado de valores atípicos y estructuración de los datos para un análisis sin fricciones.
¿Recibiré el código fuente o solo los datos limpiados finales?
Recibirás ambos. Proporcionaré el conjunto de datos limpio y bien estructurado en el formato que prefieras (p. ej., CSV, Excel) junto con el cuaderno de Jupyter (.ipynb) completo y bien documentado que contiene el código Python.
¿Puedes manejar conjuntos de datos grandes o Big Data?
Sí, puedo manejar conjuntos de datos moderadamente grandes dentro de entornos Python estándar. Si tienes archivos excepcionalmente grandes (gigabytes de datos), envíame un mensaje antes de pedir para que podamos discutir soluciones optimizadas como Dask o procesamiento por lotes.
¿Qué pasa si mis datos contienen información sensible o confidencial?
Mi primera preocupación es la privacidad de los datos. Si hace falta, con gusto firmaré un Acuerdo de Confidencialidad (NDA). También, antes de enviarme el conjunto de datos, puedes enmascarar o anonimizas cualquier columna sensible (como números de tarjetas de crédito o nombres).
¿Puedes extraer o consultar datos directamente de bases de datos MongoDB y DuckDB?
Sí. Puedo conectarme a tus colecciones de MongoDB para exportar datos JSON, o consultar tus bases de datos DuckDB para obtener y procesar datos directamente. Puedo exportar los resultados finales y limpios en formatos estándar como CSV, Excel o Parquet.


