Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
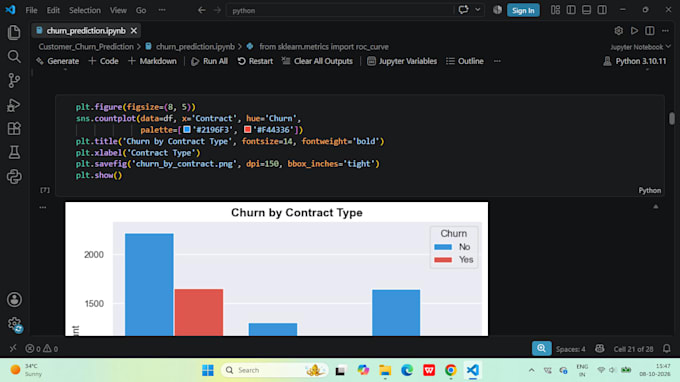
¿Datos desordenados que retrasan tus insights de negocio o pipelines de machine learning? Limpiaré, consultaré y transformaré tus conjuntos de datos en bruto usando Python y SQL para que estén listos para producción al 100%.
Lo que ofrezco:
Limpieza de datos en Python: manejo de valores faltantes, eliminación de duplicados, formateo estructural, corrección de tipos de datos y manejo de anomalías estructurales usando Pandas y NumPy.
Consultas en bases de datos SQL: escribir consultas optimizadas y limpias usando joins, funciones de ventana, operaciones agregadas y subconsultas para extraer métricas específicas.
Análisis exploratorio de datos (EDA): descubrir distribuciones ocultas, rastrear matrices de correlación y crear visualizaciones resumidas claras.
Preprocesamiento de características: manejo de valores atípicos, codificación de categorías y escalado de datos para estructurar perfectamente tus datos para análisis.
Entregables:
Recibirás notebooks de Python en formato Jupyter (.ipynb) completamente comentados, archivos de scripts limpios (.py), scripts estructurados de consultas SQL (.sql) y tus conjuntos de datos pulidos en formatos CSV/Excel.
Por favor, envíame un mensaje breve detallando el formato de tu dataset y tus objetivos analíticos antes de hacer tu pedido para que podamos definir el proyecto a la perfección.
Traducción automática
¿Qué librerías usas para la limpieza y análisis de datos en Python?
Principalmente uso Pandas y NumPy para una limpieza, preprocesamiento y manipulación eficientes de datos. Para análisis exploratorio (EDA) y visualizaciones, utilizo Matplotlib y Seaborn para crear gráficos estadísticos claros.
¿Puedes trabajar con bases de datos masivas o servidores en la nube?
¡Sí! Puedo escribir consultas SQL optimizadas para volcados de bases de datos locales (.sql) o conectarme directamente a bases de datos relacionales estándar. Para conjuntos de datos grandes, aseguro que las consultas usen joins e índices eficientes para minimizar la carga de procesamiento.