Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
Ingeniero senior en Web Scraping y especialista en extracción de datos en Python
¿Buscas extraer datos limpios y confiables de sitios web modernos con mucho javascript o aplicaciones de página única (SPA)? ¡Estás en el lugar correcto!
Soy un ingeniero senior en Web Scraping y Data y fundador de HLP Data. Construyo pipelines de crawling de nivel productivo que recolectan millones de registros estructurados semanalmente con un 99.8% de tiempo en línea.
Lo que me especializo en:
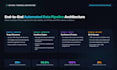
Web Scraping dinámico: automatización con navegador sin cabeza (Playwright/Chromium) para React, Vue, Next.js y portales impulsados por AJAX.
Desplazamiento infinito y paginación: extracción exhaustiva de catálogos sin perder elementos.
Manejo inteligente del tráfico: limitación de tasa por dominio y gestión de sesiones con múltiples proxies.
Formatos limpios para producción: CSV, TSV, JSON, PostgreSQL, MySQL o carga directa a Amazon AWS S3.
Incluye código fuente completo: scripts limpios en Python con guías de configuración para programación automática con cron.
¿Por qué elegirme?
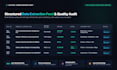
Conjuntos de datos validados al 100% (sin nulls en campos obligatorios)
Respuesta rápida en 24-48 horas
Revisiones ilimitadas y garantía de satisfacción al 100%
Por favor, envíame un mensaje con tu URL objetivo y los campos requeridos antes de ordenar. ¡Hablemos de tu proyecto!


Tecnología:
Python
•
scrapy
•
Selenium
•
Beautiful Soup
•
Playwright
Técnica:
Automatizado


