Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
Construyendo backends seguros en Python y dashboards basados en datos
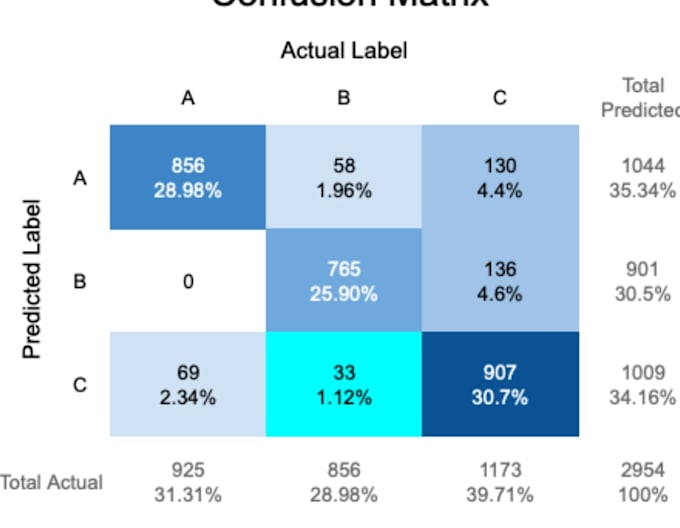
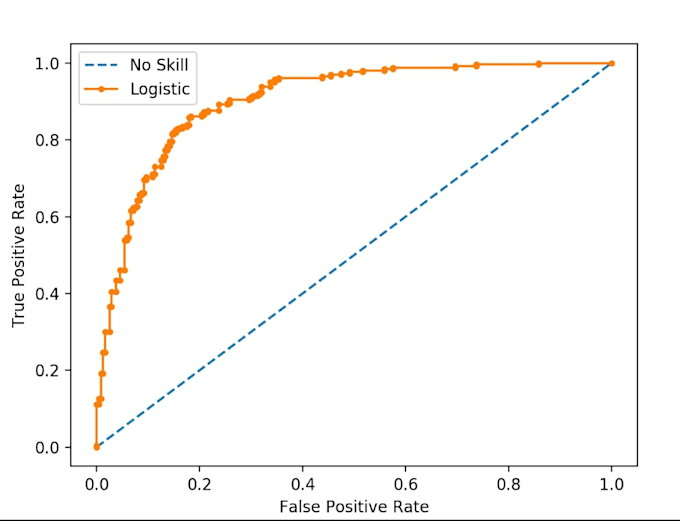
¿Necesitas un modelo robusto de Machine Learning o un pipeline de datos en Python en lugar de plantillas genéricas? Construyámoslo juntos.
Soy graduado en Ciencias de la Computación, especializado en computación estadística, preprocesamiento de datos y modelado predictivo localizado usando Python. Diseño código matemáticamente sólido para extraer insights útiles de datos en bruto sin rodeos.
LO QUE OFREZCO:
¿Por qué elegirme?
¡Envíame un mensaje con los detalles de tu dataset antes de ordenar!


Lenguaje de programación:
Python
•
SQL
Marcos:
Scikit-learn
•
keras
•
PyTorch
•
Panda
Herramientas:
Jupyter Notebook
•
TensorFlow
Traducción automática
Pregunta: ¿Cómo manejas mi dataset empresarial sensible?
Respuesta: La seguridad de tus datos es mi máxima prioridad. Manejo toda la información localmente o mediante instancias seguras de Google Colab. Nunca comparto tus datasets con terceros. Si tus datos son muy sensibles, puedes randomizar o anonimizar los valores de las columnas antes de enviármelos.
Pregunta: ¿Garantizas una precisión del 100% en el modelo?
Respuesta: No, porque la verdadera precisión depende completamente de la calidad de tu dataset. Ten cuidado con quienes prometen el 100%. Garantizo un feature engineering matemáticamente sólido, ajuste exhaustivo de hiperparámetros y pipelines de entrenamiento optimizados para lograr la puntuación más alta posible y realista.
Pregunta: ¿En qué formato recibiré los archivos finales del proyecto?
Respuesta: Recibirás un script .py limpio y listo para producción, cualquier peso de modelo entrenado o archivos serializados (como .pkl), y una guía detallada en README.md con instrucciones de configuración. También puedo ofrecerte acceso seguro mediante invitación a un repositorio privado de GitHub.
Pregunta: ¿Integrarás este modelo de machine learning en mi sitio web en vivo?
Respuesta: No, este servicio cubre exclusivamente el procesamiento de datos y la construcción de scripts de modelos localizados. No incluyo despliegues en la nube, configuración de API ni integración frontend. Entrego scripts completamente probados listos para que tu equipo de desarrollo interno o administrador del servidor los hospede.