Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
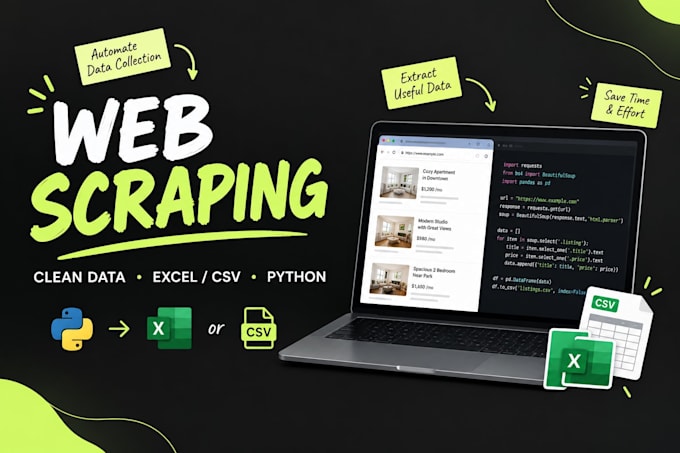
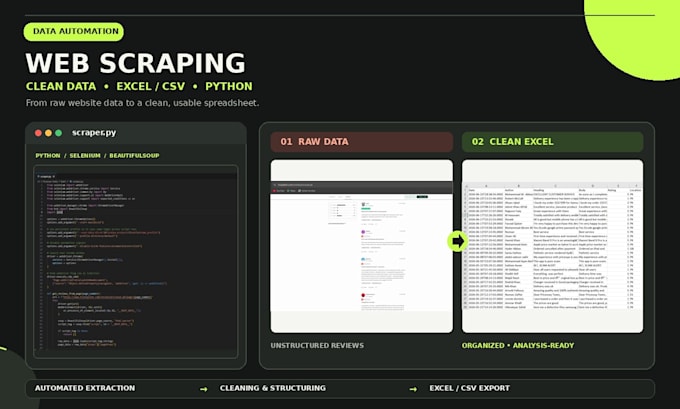
¿Necesitas datos de un sitio web en una hoja de cálculo limpia en lugar de horas copiando y pegando? Construyo scrapers personalizados en Python que recopilan datos públicos y los entregan limpios, estructurados y listos para usar.
He creado scrapers y pipelines de limpieza que recopilaron más de 500 reseñas de clientes para una plataforma de comercio electrónico, así que estoy acostumbrado a datos desordenados, en varios idiomas y de varias páginas.
Lo que puedo rastrar:
- Listados de productos, precios y especificaciones
- Reseñas y valoraciones de clientes
- Directorios de empresas y datos de contacto
- Empleos y otras páginas públicas
Lo que obtendrás:
- Excel, CSV o JSON, con duplicados eliminados y columnas limpias
- Sitios dinámicos y paginados manejados (Selenium)
- Standards y Premium: el script de Python funcional
- Premium: una corrección gratis si el sitio cambia dentro de 14 días
Cómo funciona:
1. Envíame el enlace del sitio y los campos que necesitas
2. Confirmo que es posible y sugiero el paquete adecuado
3. Entrego, tú revisas, ajusto
Solo rastró datos públicos y respeto los términos de los sitios. Datos de contacto: solo información comercial pública, nunca datos de personas privadas. Sin login, CAPTCHA ni saltos de paywall.
Envíame tu enlace antes de hacer el pedido.
Tecnología:
Python
•
scrapy
•
Selenium
•
Beautiful Soup
•
Pandas
Técnica:
Automatizado
Traducción automática
¿Qué necesitas de mí para empezar?
El enlace del sitio, los campos exactos que quieres (p. ej. nombre del producto, precio, puntuación), y tu formato preferido. Una página es una página web de resultados, y una página puede listar 10 o 50 items. Si necesitas un número concreto de filas, dímelo y recomendaré el paquete adecuado.
¿Puedes raspar cualquier sitio web?
Puedo manejar la mayoría de sitios públicos, pero algunos usan protecciones anti-bot fuertes o prohíben el scraping en sus términos. Envíame el enlace y lo confirmaré antes de que hagas el pedido.
¿Qué formatos entregas?
Excel, CSV o JSON. Google Sheets está disponible como extra.
¿Obtengo el script del scraper?
Sí, en Standard y Premium, y necesitas tener Python instalado para ejecutarlo. Basic es solo datos, y el script está disponible como extra.
¿Qué pasa si el sitio cambia después?
Los scrapers pueden dejar de funcionar si rediseñan un sitio. Premium incluye una corrección gratis dentro de 14 días desde la entrega. Después de eso, o en otros paquetes, puedo actualizarlo por una pequeña tarifa. Solo escríbeme.
¿Rastrás datos de contacto?
Solo datos comerciales que una empresa publica, como la dirección de la tienda, teléfono de la empresa y sitio web. No recojo correos electrónicos o números de teléfono de personas privadas.