Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
Ingeniero de datos sénior
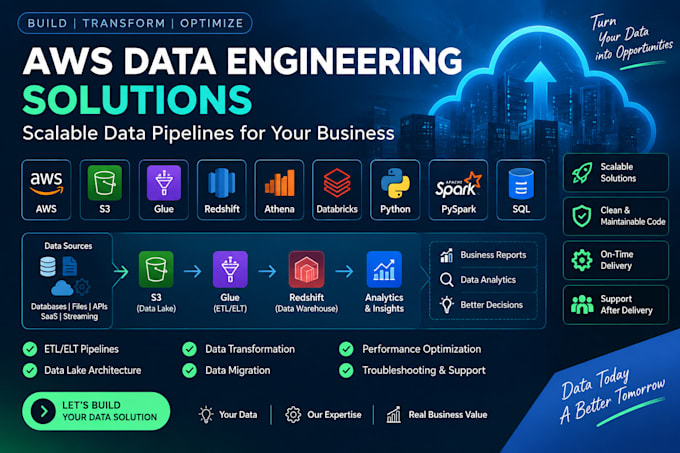
¿Buscas un Ingeniero de Datos con experiencia para construir pipelines de datos confiables y escalables?
Desarrollaré y optimizaré soluciones de ingeniería de datos en AWS, ETL/ELT y procesamiento de datos usando Python, PySpark, SQL, AWS Glue, S3, Redshift, Athena y Databricks.
Esto es lo que puedo ayudarte a hacer:
Me enfoco en crear soluciones de datos limpias, escalables, fáciles de mantener y listas para producción según las necesidades de tu negocio.
Ya sea que necesites un nuevo pipeline de datos, optimizar un flujo de trabajo existente o ayuda para solucionar problemas en tu proyecto de ingeniería de datos, puedo ayudarte.
Tecnologías: AWS | Python | PySpark | SQL | Glue | S3 | Redshift | Athena | Databricks | Delta Lake
Experiencia:
CI/CD
•
Supervisión y registro
•
Automatización
Proveedor de la nube:
Amazon Web Services
